벤처캐피털리스트 Tomasz Tunguz(토마스 퉁구즈)는 8월 18일 글에서 작은 로컬 모델이 큰 클라우드 모델과 비슷한 품질을 내더라도 답에 도달하는 경로는 전혀 다를 수 있다고 설명했습니다.
먼저 이 글의 이해관계부터 밝혀야 합니다. 퉁구즈는 AI와 인프라 스타트업에 투자하는 Theory Ventures의 파트너이므로 오픈 모델과 로컬 추론 확산을 긍정적으로 해석할 유인이 있을 수 있습니다. 따라서 그가 제시한 실험은 흥미로운 현장 자료이지만, 공식 벤치마크나 투자 권고가 아니라 저자가 직접 수행한 비공식 테스트로 읽어야 합니다.
제가 이 글에서 중요하다고 본 지점은 작은 모델이 큰 모델을 이겼다는 단순한 이야기가 아닙니다. 같은 답을 내더라도 모델이 사용하는 파라미터와 추론 토큰, 지연시간이 다르면 AI 인프라에 필요한 비용과 장비의 종류도 달라집니다. 모델 크기만 보고 수요를 추정하던 방식에서 벗어나야 할 시점입니다.
작은 모델은 큰 모델과 다른 길로 답에 도착합니다
퉁구즈는 자신의 에이전트에 Qwen3.8-27B를 넣어 사용해본 뒤, 클라우드의 대형 모델과 비슷한 품질을 내면서도 훨씬 작은 모델이 노트북에서 실행될 수 있다는 점에 주목했습니다. Qwen3.8-27B는 공식 모델 카드 기준 270억 개 파라미터 모델입니다. Qwen3.6-35B-A3B는 전체 350억 개 파라미터를 갖지만 토큰마다 약 30억 개만 활성화하는 희소 혼합 전문가 모델입니다.
여기서 모델 크기와 실제 계산량을 구분해야 합니다. 조밀한 모델은 매 토큰마다 전체 파라미터를 사용하는 반면, 혼합 전문가 구조는 질문에 필요한 일부 전문가만 불러올 수 있습니다. 전체 파라미터가 크더라도 실제로 한 번의 추론에 사용하는 활성 파라미터가 작다면 메모리와 연산 부담이 달라질 수 있습니다.
퉁구즈가 제시한 설명은 이렇습니다. 큰 모델은 더 많은 지식을 이미 저장하고 있어 답으로 바로 이동할 수 있지만, 작은 모델은 부족한 지식을 추론 과정으로 메워야 할 수 있습니다. 이 설명은 모든 모델에 일반화된 법칙이라기보다, 이번 비교에서 관찰된 토큰 수와 지연시간 차이를 설명하는 하나의 가설로 보는 편이 안전합니다.
같은 품질이어도 완료시간은 달랐습니다
퉁구즈는 스타트업 조사, 기사 요약, 팟캐스트 전사 등 25개의 벤처캐피털 업무를 직접 골라 세 모델을 비교했습니다. 별도의 판정 모델이 완성도·정확성·간결성을 각각 3점씩 평가해 9점 만점으로 점수를 냈고, 로컬 모델은 같은 Ollama와 MLX 실행환경에서 돌렸다고 설명했습니다. 동일한 출력을 다시 평가해 판정 모델의 변동성도 확인했지만, 표본이 25개 작업에 불과하다는 한계는 남습니다.
결과는 흥미로웠습니다. DeepSeek V4 Flash는 품질 8.0점, 초당 137.3토큰, 평균 159토큰, 평균 지연시간 1.1초였습니다. Qwen3.8-27B는 품질 8.0점으로 비슷했지만 초당 51.9토큰을 생성하고 평균 369토큰을 사용해 지연시간이 7.2초였습니다. Qwen3.6-35B-A3B는 품질 7.9점, 초당 113.4토큰으로 빠르게 생성했지만 평균 1,143토큰을 사용해 지연시간은 10초였습니다.
이 숫자에서 흔히 놓치는 부분은 토큰 속도와 작업 완료시간이 다르다는 사실입니다. Qwen3.6은 토큰을 빠르게 생성했지만 생각하는 토큰이 훨씬 많아 최종 답변은 가장 늦었습니다. 반대로 클라우드 모델은 답을 바로 내놓는 대신 더 큰 모델과 더 많은 서버 자원을 사용했을 가능성이 있습니다.
따라서 사용자가 지불하는 것은 초당 토큰 수가 아니라 일을 끝내는 데 걸린 시간과 비용입니다. 기업의 입장에서는 모델이 1초에 몇 토큰을 출력하는지보다 하나의 업무를 완료하는 데 몇 초와 몇 원이 들고, 사람이 얼마나 다시 손을 봐야 하는지가 중요합니다.
AI 인프라의 병목은 모델 크기에서 작업당 비용으로 이동합니다
지금까지 AI 인프라 투자는 더 큰 모델을 훈련하고 더 많은 GPU를 배치하는 방향으로 설명됐습니다. 그러나 소형 모델이 충분한 품질을 내고 로컬 장비에서 실행된다면 기업은 업무마다 다른 모델을 선택할 수 있습니다. 보안이 중요한 문서와 반복적인 분류 업무는 사내 모델로 처리하고, 복잡한 판단과 긴 문맥이 필요한 작업만 클라우드 모델로 보낼 수 있습니다.
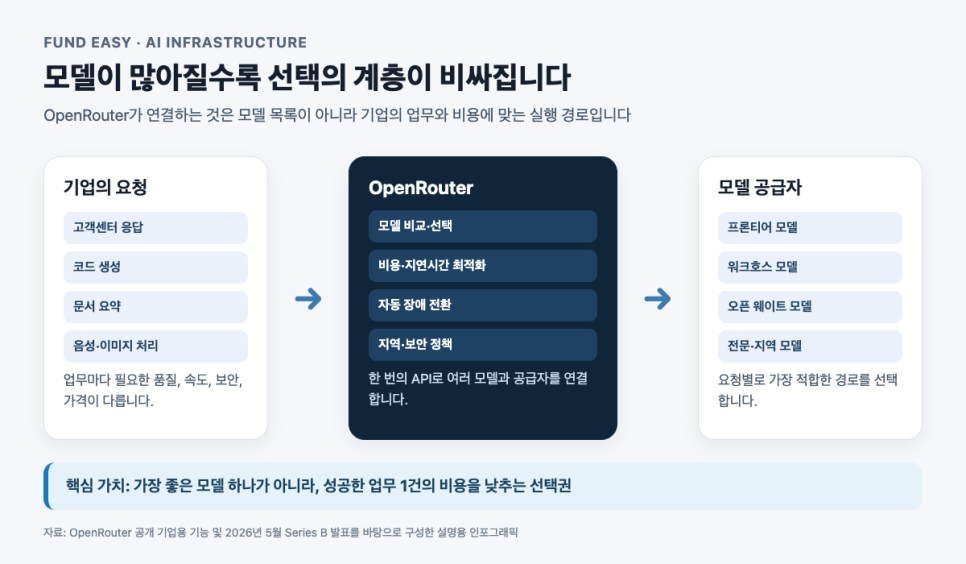
이 구조에서는 모델 라우팅이 새로운 병목이 됩니다. 어떤 모델이 가장 똑똑한지가 아니라, 품질·비용·지연시간·데이터 보안·가용성을 동시에 만족하는 모델을 자동으로 고르는지가 중요해집니다. 기업의 AI 시스템은 하나의 거대한 모델이라기보다 여러 모델을 업무별로 배치하는 운영체제에 가까워질 수 있습니다.
이 변화는 GPU 수요가 사라진다는 뜻도 아닙니다. 토큰당 비용이 낮아지면 기업이 더 많은 업무를 자동화하고, 더 긴 에이전트 작업을 실행하고, 더 많은 데이터를 반복 처리할 가능성이 있습니다. 단가 하락이 사용량 증가로 이어지면 전체 토큰 수와 추론량은 오히려 늘어날 수 있습니다. 다만 가격 하락이 신규 업무와 실제 배포로 연결되지 않고 기존 클라우드 사용량만 대체한다면 하드웨어 수요에는 부정적일 수 있습니다.
결국 확인해야 할 것은 단순한 모델 성능이 아닙니다. 비용 하락이 실제 업무 수와 에이전트 실행 횟수를 늘리는지, 아니면 같은 업무를 더 싸게 처리하는 데 그치는지 구분해야 합니다. 이 차이가 AI 반도체 수요의 방향을 결정할 수 있습니다.
좋은 모델과 좋은 AI 주식은 다릅니다
Qwen3.6-35B-A3B처럼 활성 파라미터가 작은 모델이 큰 모델과 비슷한 품질을 낸다는 사실은 모델 개발자에게는 기회입니다. 하지만 이것만으로 모든 AI 반도체 기업의 장기 수요가 안전하다고 말할 수는 없습니다. 소형 모델은 메모리 용량 부담을 낮출 수 있지만 더 긴 추론 토큰, 높은 동시성, 긴 컨텍스트, 검색과 도구 호출을 요구할 수 있습니다.
반도체 투자자는 모델의 총 파라미터보다 실제 배포 구조를 봐야 합니다. 첫째, 한 작업에 필요한 활성 파라미터와 추론 토큰이 얼마나 되는지 확인해야 합니다. 둘째, 모델이 로컬·프라이빗 환경으로 이동할 때 서버용 GPU와 메모리 수요가 어떤 장비로 옮겨가는지 봐야 합니다. 셋째, 모델 라우팅과 에이전트 실행이 늘어날 때 네트워크, 저장장치, 전력과 냉각 수요가 어떻게 변하는지 확인해야 합니다.
좋은 기업이라는 판단과 좋은 주식이라는 판단도 다릅니다. AI 모델의 품질이 높아지고 비용이 내려가도 그 기대가 이미 주가에 반영됐다면 투자 매력은 낮을 수 있습니다. 반대로 모델 단가가 하락해도 총사용량과 고객의 유료 배포가 빠르게 늘어난다면 인프라 기업에는 새로운 성장 경로가 열릴 수 있습니다.
앞으로 확인할 숫자
첫째는 작업당 비용과 완료시간입니다. 토큰 단가나 초당 생성속도만 보지 말고, 하나의 업무를 끝내는 데 사용한 총 토큰, 지연시간, 사람의 개입 횟수와 실패율을 함께 봐야 합니다.
둘째는 로컬 추론과 클라우드 추론의 실제 배치 비중입니다. 오픈 모델 다운로드 수보다 기업이 실제로 사내 서버와 엣지 장비에서 얼마나 많은 추론을 실행하는지가 중요합니다. 로컬 모델이 늘면 클라우드 매출이 줄어드는지, 아니면 더 많은 업무가 새로 자동화되는지 확인해야 합니다.
셋째는 하드웨어 사용량입니다. GPU 가동률, HBM과 메모리 대역폭, 네트워크 장비 주문, 데이터센터 전력 사용량, 고객의 설비투자와 잉여현금흐름을 함께 봐야 합니다. 모델이 작아졌다는 사실 하나만으로 하드웨어 수요가 줄어든다고 가정해서는 안 됩니다.
넷째는 기업 도입의 질입니다. AI가 실제 업무를 끝까지 수행하는 자동완료율, 사람의 수정 비율, 도구 호출 성공률, 고객 유지율과 유료 좌석 수가 늘어나는지 확인해야 합니다. 벤치마크 점수보다 실제 업무에 반복적으로 배치되는지가 더 중요한 단계로 넘어가고 있습니다.
정리하면 작은 AI 모델이 큰 모델과 비슷한 답을 낸다는 사실은 AI 경쟁의 끝이 아니라 비용 구조의 변화를 보여줍니다. 같은 품질을 더 작은 모델로 만들 수 있다면 모델 단가와 진입장벽은 낮아질 수 있지만, 그 결과 더 많은 업무와 더 긴 추론이 실행되면 전체 인프라 수요는 오히려 커질 수 있습니다.
제 관점에서는 이번 글을 소형 모델이 대형 모델과 클라우드 인프라를 대체한다는 이야기로 읽기보다, AI 수요를 측정하는 단위가 모델 크기에서 작업당 비용과 완료시간으로 바뀐다는 신호로 읽는 편이 맞습니다. AI의 다음 톨게이트는 가장 큰 모델을 보유한 기업이 아니라, 여러 모델을 가장 효율적으로 연결해 실제 업무를 끝내는 시스템이 될 수 있습니다.
출처: Tomasz Tunguz의 「Birds Don’t Fly Like Planes. Neither Does AI.」(2026년 8월 18일)을 바탕으로 작성했습니다. Qwen 모델의 파라미터 구조는 Qwen 공식 발표와 모델 자료를 대조했고, 퉁구즈의 25개 작업 비교는 저자 개인의 비공식 테스트로 구분했습니다. 본문에 삽입한 비교 인포그래픽은 원문 수치를 바탕으로 Fund Easy가 재구성했습니다.
이 글은 특정 종목의 매수나 매도를 권하는 투자 조언이 아닙니다. 원문의 저자는 AI와 인프라 스타트업에 투자하는 Theory Ventures 파트너이므로 오픈 모델과 로컬 추론 확산에 이해관계가 있을 수 있습니다. 또한 25개 작업의 자체 테스트는 표본과 작업 구성, 모델 버전, 실행환경에 따라 결과가 달라질 수 있으며 공식 벤치마크를 의미하지 않습니다. AI 모델의 가격 경쟁, 추론 비용, 데이터 보안, 모델 라우팅, GPU와 메모리 가동률, 데이터센터 전력과 고객의 자본지출에 따라 관련 기업의 실적과 주가 변동성이 커질 수 있습니다. 투자 전에는 실제 고객 배포, 작업당 비용, 현금흐름, 자본지출, 밸류에이션을 직접 확인하시기 바랍니다. 투자 판단과 그 책임은 투자자 각자에게 있습니다.

 22